Streaming ELT 同步 MySQL 到 Kafka
这篇教程将展示如何基于 Flink CDC 快速构建 MySQL 到 Kafka 的 Streaming ELT 作业,包含整库同步、表结构变更同步和分库分表同步的功能。
本教程的演示都将在 Flink CDC CLI 中进行,无需编写 Java 或 Scala 代码,也无需安装 IDE。
准备阶段
准备一台已经安装了 Docker 的 Linux 或者 macOS 电脑。
准备 Flink Standalone 集群
-
下载 Flink 1.20.5,解压后得到 flink-1.20.5 目录。 使用下面的命令跳转至 Flink 目录下,并且设置
FLINK_HOME为 flink-1.20.5 所在目录。tar -zxvf flink-1.20.5-bin-scala_2.12.tgzexport FLINK_HOME=$(pwd)/flink-1.20.5cd flink-1.20.5 -
在
conf/config.yaml配置文件追加下列参数开启检查点,每隔 3 秒进行一次 checkpoint。execution:checkpointing:interval: 3s -
使用下面的命令启动 Flink 集群。
./bin/start-cluster.sh
启动成功后,即可在 http://localhost:8081/ 访问到 Flink Web UI,如下所示:
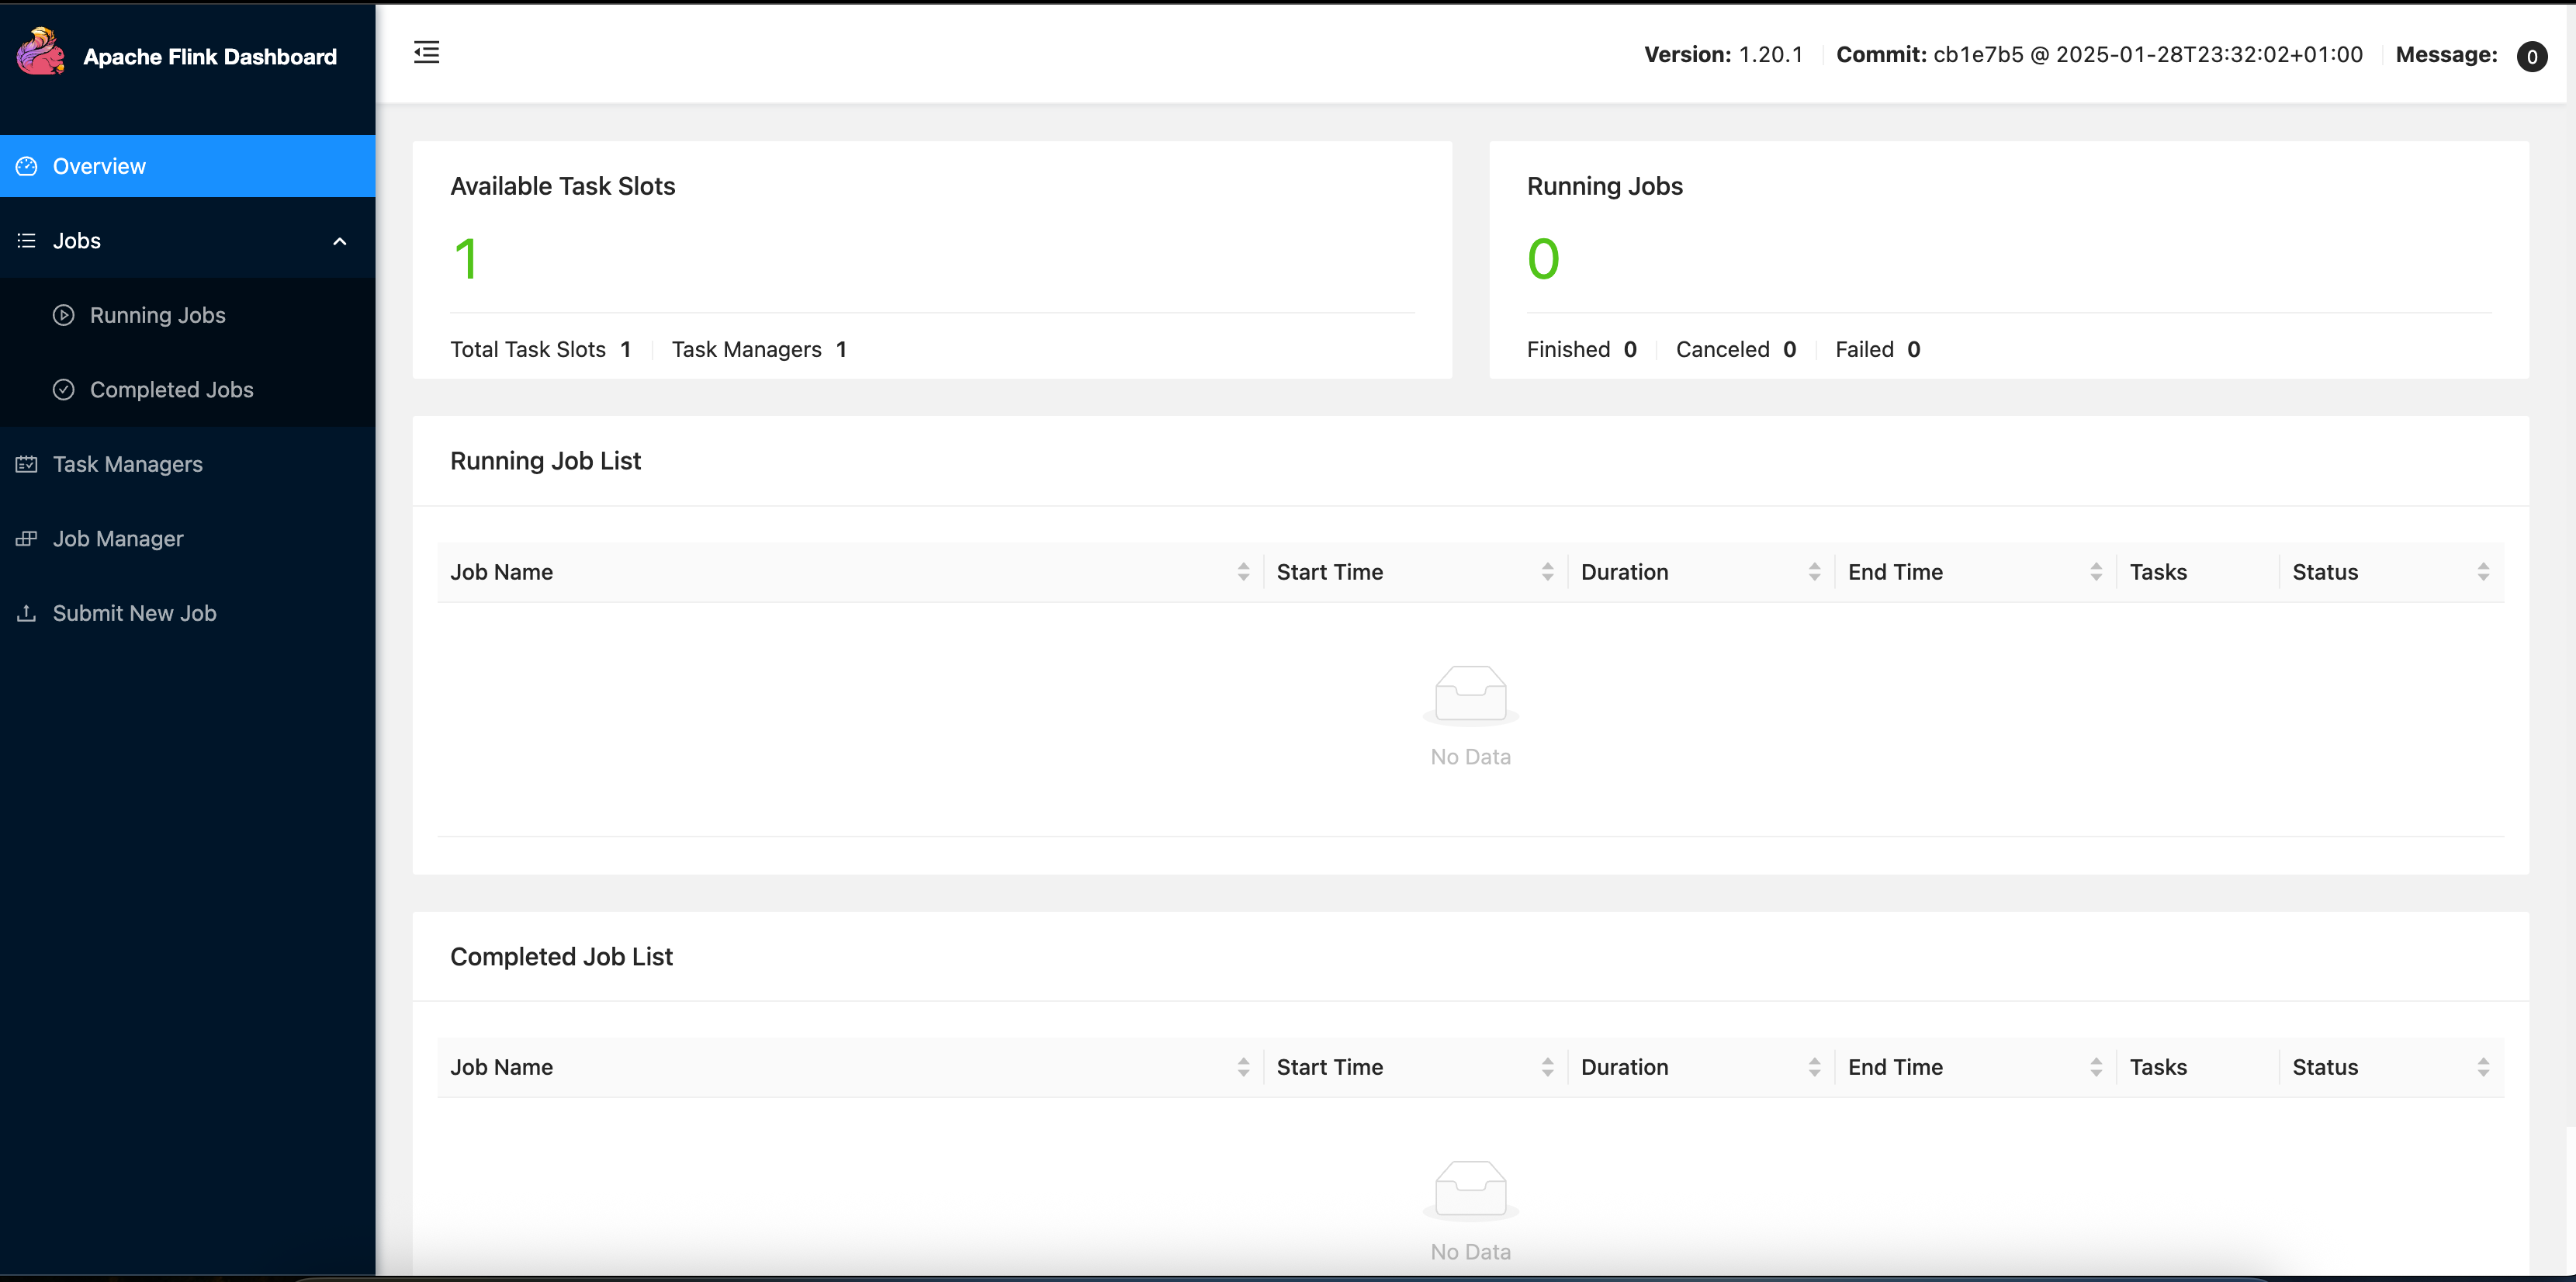
多次执行 start-cluster.sh 可以拉起多个 TaskManager。
注:如果您的 Flink 搭建在云服务器上,则需要将 conf/config.yaml 中的 rest.bind-address 和 rest.address 配置修改为 0.0.0.0,然后使用公网 IP 访问。
准备 Docker 环境
创建一个 docker-compose.yml 文件并写入以下内容:
version: '2.1'
services:
  Zookeeper:
    image: zookeeper:3.7.1
    ports:
      - "2181:2181"
    environment:
      - ALLOW_ANONYMOUS_LOGIN=yes
  Kafka:
    image: bitnami/kafka:2.8.1
    ports:
      - "9092:9092"
      - "9093:9093"
    environment:
      - ALLOW_PLAINTEXT_LISTENER=yes
      - KAFKA_LISTENERS=PLAINTEXT://:9092
      - KAFKA_ADVERTISED_LISTENERS=PLAINTEXT://Kafka:9092
      - KAFKA_ZOOKEEPER_CONNECT=Zookeeper:2181
  MySQL:
    image: debezium/example-mysql:1.1
    ports:
      - "3306:3306"
    environment:
      - MYSQL_ROOT_PASSWORD=123456
      - MYSQL_USER=mysqluser
      - MYSQL_PASSWORD=mysqlpw
配置文件中的 192.168.67.2 为容器内网 IP,可通过 ifconfig 命令确定。
该 Docker Compose 将拉起以下容器:
- MySQL:数据管道的源头
- Kafka:数据管道的下游
- Zookeeper:用于 Kafka 集群管理和协调
在 docker-compose.yml 所在目录下执行下面的命令来启动本教程需要的组件:
docker compose up -d
该命令将以 detached 模式自动启动 Docker Compose 配置中定义的所有容器。你可以通过执行 docker ps 命令来观察上述的容器是否正常启动,如下图所示。

在 MySQL 数据库中准备数据
-
进入 MySQL 容器
docker compose exec MySQL mysql -uroot -p123456 -
创建数据库
app_db和表orders,products,shipments,并插入数据-- 创建数据库CREATE DATABASE app_db;USE app_db;-- 创建 orders 表CREATE TABLE `orders` (`id` INT NOT NULL,`price` DECIMAL(10,2) NOT NULL,PRIMARY KEY (`id`));-- 插入数据INSERT INTO `orders` (`id`, `price`) VALUES (1, 4.00);INSERT INTO `orders` (`id`, `price`) VALUES (2, 100.00);-- 创建 shipments 表CREATE TABLE `shipments` (`id` INT NOT NULL,`city` VARCHAR(255) NOT NULL,PRIMARY KEY (`id`));-- 插入数据INSERT INTO `shipments` (`id`, `city`) VALUES (1, 'beijing');INSERT INTO `shipments` (`id`, `city`) VALUES (2, 'xian');-- 创建 products 表CREATE TABLE `products` (`id` INT NOT NULL,`product` VARCHAR(255) NOT NULL,PRIMARY KEY (`id`));-- 插入数据INSERT INTO `products` (`id`, `product`) VALUES (1, 'Beer');INSERT INTO `products` (`id`, `product`) VALUES (2, 'Cap');INSERT INTO `products` (`id`, `product`) VALUES (3, 'Peanut');
通过 Flink CDC CLI 提交任务
下载链接只对已发布的版本有效,SNAPSHOT 版本需要本地基于 master 或 release- 分支编译。
-
下载下面列出的二进制压缩包,并解压得到目录
flink-cdc-3.8-SNAPSHOT;
flink-cdc-3.8-SNAPSHOT-bin.tar.gz flink-cdc-3.8-SNAPSHOT 下会包含bin、lib、log、conf四个目录。 -
下载下面列出的 connector 包,并且移动到 lib 目录下; 请注意,您需要将 jar 移动到 Flink CDC Home 的 lib 目录,而非 Flink Home 的 lib 目录下。
您还需要将下面的 Driver 包放在 Flink
lib目录下,或通过--jar参数将其传入 Flink CDC CLI,因为 CDC Connectors 不再包含这些 Drivers: -
编写任务配置 yaml 文件。 下面给出了一个整库同步的示例文件
mysql-to-kafka.yaml:################################################################################# Description: Sync MySQL all tables to Kafka################################################################################source:type: mysqlhostname: 0.0.0.0port: 3306username: rootpassword: 123456tables: app_db.\.*server-id: 5400-5404server-time-zone: UTCsink:type: kafkaname: Kafka Sinkproperties.bootstrap.servers: 0.0.0.0:9092topic: yaml-mysql-kafkapipeline:name: MySQL to Kafka Pipelineparallelism: 1
其中:
- source 中的
tables: app_db.\.*通过正则匹配同步app_db下的所有表。
-
最后,通过命令行提交任务到 Flink Standalone cluster
bash bin/flink-cdc.sh mysql-to-kafka.yaml如果作业提交成功,将打印以下信息:
Pipeline has been submitted to cluster.Job ID: 04fd88ccb96c789dce2bf0b3a541d626Job Description: MySQL to Kafka Pipeline在 Flink Web UI,可以看到一个名为
Sync MySQL Database to Kafka的任务正在运行。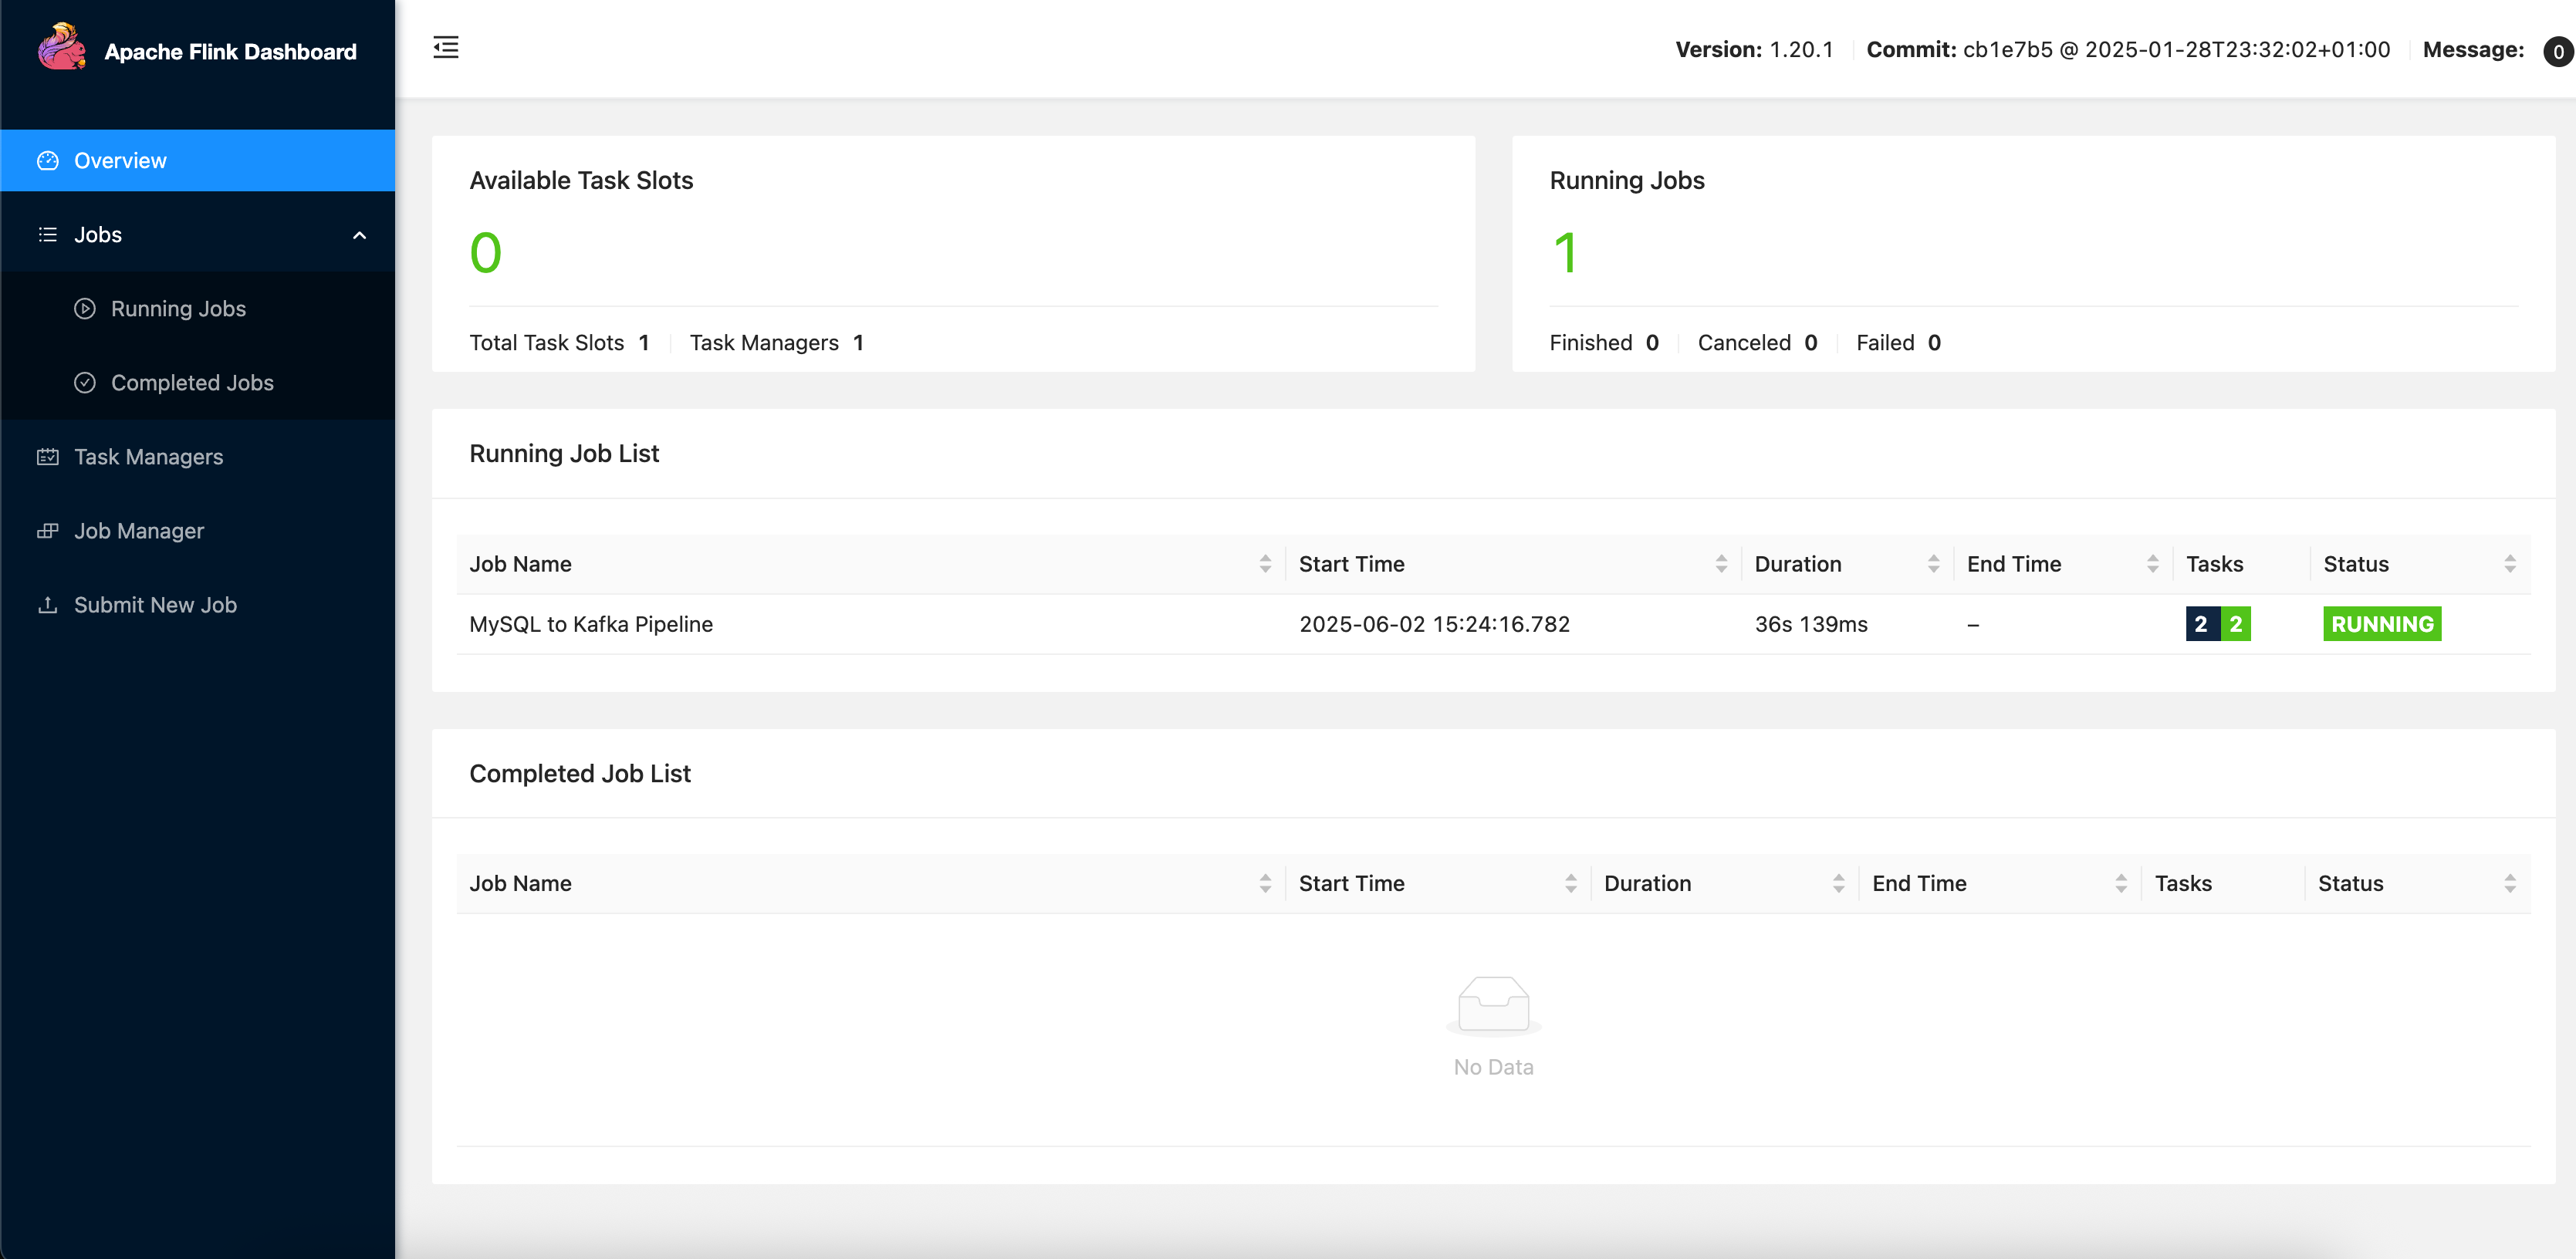
您可以通过 Kafka 提供的命令行工具查看 Topic 中的消息,像这样:
docker compose exec Kafka kafka-console-consumer.sh --bootstrap-server 0.0.0.0:9092 --topic yaml-mysql-kafka --from-beginningdebezium-json 格式包含了 before、after、op、source 字段。一条示例信息如下所示:
{"before": null,"after": {"id": 1,"price": 4},"op": "c","source": {"db": "app_db","table": "orders"}}// ...{"before": null,"after": {"id": 1,"product": "Beer"},"op": "c","source": {"db": "app_db","table": "products"}}// ...{"before": null,"after": {"id": 2,"city": "xian"},"op": "c","source": {"db": "app_db","table": "shipments"}}
同步变更
我们使用以下命令进入 MySQL 容器:
docker compose exec mysql mysql -uroot -p123456
接下来,修改 MySQL 数据库中表的数据,Kafka 中显示的订单数据也将实时更新:
-
在 MySQL 的
orders表中插入一条数据;INSERT INTO app_db.orders (id, price) VALUES (3, 100.00); -
在 MySQL 的
orders表中增加一个字段;ALTER TABLE app_db.orders ADD amount varchar(100) NULL; -
在 MySQL 的
orders表中更新一条数据;UPDATE app_db.orders SET price=100.00, amount=100.00 WHERE id=1; -
在 MySQL 的
orders表中删除一条数据;DELETE FROM app_db.orders WHERE id=2;
使用上一节中提到的命令观察下游 Topic,我们可以看到实时变更的消息记录:
{
    "before": {
        "id": 1,
        "price": 4,
        "amount": null
    },
    "after": {
        "id": 1,
        "price": 100,
        "amount": "100.00"
    },
    "op": "u",
    "source": {
        "db": "app_db",
        "table": "orders"
    }
}
同样的,去修改 shipments, products 表,也能在 Kafka 中对应的 topic 实时看到同步变更的结果。
路由变更
Flink CDC 提供了将源表的表结构/数据路由到其他表名的配置,借助这种能力,我们能够实现表名库名替换、整库同步等功能。
下面是一个示例配置文件:
################################################################################
# Description: Sync MySQL all tables to Kafka
################################################################################
source:
  type: mysql
  hostname: localhost
  port: 3306
  username: root
  password: 123456
  tables: app_db.\.*
  server-id: 5400-5404
  server-time-zone: UTC

sink:
  type: kafka
  name: Kafka Sink
  properties.bootstrap.servers: 0.0.0.0:9092
pipeline:
  name: MySQL to Kafka Pipeline
  parallelism: 1
route:
  - source-table: app_db.orders
    sink-table: kafka_ods_orders
  - source-table: app_db.shipments
    sink-table: kafka_ods_shipments
  - source-table: app_db.products
    sink-table: kafka_ods_products
以上这些 route 规则会将 app_db 中三张表的结构和数据分发到三个不同的下游 Topic 中。
特别地,source-table 支持正则表达式匹配多表,从而实现分库分表同步的功能,例如,如果编写这样的规则:
route:
- source-table: app_db.order\.*
  sink-table: kafka_ods_orders
可以将 app_db 数据库中的所有表合并成一张表,并发送到 kafka_ods_orders Topic 中。
使用 kafka-console-consumer.sh 查询:
docker compose exec Kafka kafka-topics.sh --bootstrap-server 0.0.0.0:9092 --list
可以看到新创建的 Kafka Topic 如下:
- __consumer_offsets
- kafka_ods_orders
- kafka_ods_products
- kafka_ods_shipments
- yaml-mysql-kafka
选取 kafka_ods_orders Topic 进行查询,返回数据示例如下:
{
    "before": null,
    "after": {
        "id": 1,
        "price": 100,
        "amount": "100.00"
    },
    "op": "c",
    "source": {
        "db": null,
        "table": "kafka_ods_orders"
    }
}
写入多个分区
使用 partition.strategy 参数可以定义发送数据到 Kafka 分区的策略。可以设置的选项有:
all-to-zero(将所有数据发送到 0 号分区),默认值hash-by-key(所有数据根据主键的哈希值分发)
我们在 mysql-to-kafka.yaml 的 sink 块中增加 partition.strategy: hash-by-key 配置:
source:
  # ...
sink:
  # ...
  topic: yaml-mysql-kafka-hash-by-key
  partition.strategy: hash-by-key
pipeline:
  # ...
同时,我们在 Kafka 中新建一个 12 分区的 Topic:
docker compose exec Kafka kafka-topics.sh --create --topic yaml-mysql-kafka-hash-by-key --bootstrap-server 0.0.0.0:9092 --partitions 12
并通过下面的命令查看各个分区的数据。
docker compose exec Kafka kafka-console-consumer.sh --bootstrap-server=0.0.0.0:9092 --topic yaml-mysql-kafka-hash-by-key --partition 0 --from-beginning
部分分区数据详情如下:
// 分区 0
{
    "before": null,
    "after": {
        "id": 1,
        "price": 100,
        "amount": "100.00"
    },
    "op": "c",
    "source": {
        "db": "app_db",
        "table": "orders"
    }
}
// 分区 4
{
    "before": null,
    "after": {
        "id": 2,
        "product": "Cap"
    },
    "op": "c",
    "source": {
        "db": "app_db",
        "table": "products"
    }
}
{
    "before": null,
    "after": {
        "id": 1,
        "city": "beijing"
    },
    "op": "c",
    "source": {
        "db": "app_db",
        "table": "shipments"
    }
}
输出格式
value.format 参数用于序列化 Kafka 消息的值部分数据的格式。
可选值包括 debezium-json 和 canal-json。
默认值为 debezium-json。目前不支持用户自定义输出格式。
debezium-json格式会包含before(变更前的数据)、after(变更后的数据)、op(变更类型)、source(元数据)字段。canal-json格式会包含old、data、type、database、table、pkNames字段。ts_ms字段默认不会包含在输出结构中(需要与 MySQL Source 的metadata.list参数配合使用)。
可以在 YAML sink 块中添加 value.format: canal-json 参数来指定输出格式为 Canal JSON 类型:
source:
  # ...

sink:
  # ...
  topic: yaml-mysql-kafka-canal
  value.format: canal-json
pipeline:
  # ...
查询对应 Topic 的数据,返回示例如下:
{
    "old": null,
    "data": [
        {
            "id": 1,
            "price": 100,
            "amount": "100.00"
        }
    ],
    "type": "INSERT",
    "database": "app_db",
    "table": "orders",
    "pkNames": [
        "id"
    ]
}
表名到 Topic 的映射关系
使用 sink.tableId-to-topic.mapping 参数可以指定上游表名到下游 Kafka Topic 名的映射关系。无需使用 route 配置。
与之前介绍的通过 route 实现的不同点在于,配置该参数可以在保留上游各源表的表名和表结构的同时,将来自特定表的数据派发到相应的 Kafka topic。
在前面的 YAML 文件中增加 sink.tableId-to-topic.mapping 配置指定映射关系。
每组映射关系由 ; 分割,上游表的 TableId(支持正则表达式匹配)和下游 Kafka 的 topic 名由 : 分割:
source:
  # ...

sink:
  # ...
  sink.tableId-to-topic.mapping: app_db.orders:yaml-mysql-kafka-orders;app_db.shipments:yaml-mysql-kafka-shipments;app_db.products:yaml-mysql-kafka-products
pipeline:
  # ...
运行后,Kafka 中将会创建如下的 topic:
- yaml-mysql-kafka-orders
- yaml-mysql-kafka-products
- yaml-mysql-kafka-shipments
每个 Topic 中的消息如下所示:
-
yaml-mysql-kafka-orders{"before": null,"after": {"id": 1,"price": 100,"amount": "100.00"},"op": "c","source": {"db": "app_db","table": "orders"}} -
yaml-mysql-kafka-products{"before": null,"after": {"id": 2,"product": "Cap"},"op": "c","source": {"db": "app_db","table": "products"}} -
yaml-mysql-kafka-shipments{"before": null,"after": {"id": 2,"city": "xian"},"op": "c","source": {"db": "app_db","table": "shipments"}}
环境清理
实验结束后,在 docker-compose.yml 文件所在的目录下执行如下命令停止所有容器:
docker compose down
在 Flink 所在目录 flink-1.20.5 下执行如下命令停止 Flink 集群:
./bin/stop-cluster.sh
Copyright © 2026 The Apache Software Foundation. Apache Flink, Flink, and the Flink logo are trademarks of The Apache Software Foundation.